
In vielen kleinen Unternehmen beginnt KI so: Jemand im Büro hat ein privates Konto bei ChatGPT oder einem anderen Dienst, kopiert eine Kundenmail, ein Angebot oder eine Excel-Liste hinein und lässt sich etwas formulieren oder auswerten. Manchmal ist das Ergebnis gut, oft mittelmäßig und hin und wieder falsch, ohne dass es jemand merkt.
Am Modell liegt das selten. Ein Sprachmodell arbeitet nur mit dem, was es zu sehen bekommt. Im privaten Chat ist das der kopierte Ausschnitt, ohne Ihre Preise, Ihre Kundengeschichte und Ihre Regeln. Dazu kommt, dass die Daten den Betrieb ohne Vertrag verlassen.
Dieser Beitrag zeigt, wie es besser geht: mit einem dienstlichen Zugang, mit Kontext, den jemand vorab plant, und mit Daten, die geordnet vorliegen. Es geht um KI, die mit betrieblichen Daten arbeitet, etwa mit Prüfprotokollen, Rechnungen und Servicefällen. Für das Formulieren von Texten gilt vieles davon nicht. Es geht auch um Agenten: KI, die nicht nur antwortet, sondern selbstständig Schritte ausführt, etwa Daten abfragt, Einträge anlegt oder Vorgänge weiterleitet.
Das Wichtigste in Kürze
- Ein privates KI-Konto ist für Betriebsdaten der falsche Ort. Es fehlt ein Vertrag zur Auftragsverarbeitung. Je nach Tarif und Einstellung dienen Ihre Eingaben dem Training künftiger Modelle.
- Schlechte Antworten liegen meist am fehlenden Kontext, nicht am Modell. Was eine KI wissen muss, sollte geplant bereitliegen, statt jedes Mal hineinkopiert zu werden. Das nennt man Context Engineering.
- Die Suche in eigenen Dokumenten (RAG) hilft bei Fragen, deren Antwort in wenigen Absätzen steht. Für Fristen, Summen und Vollständigkeit braucht es Felder.
- Die KI arbeitet mit einem eigenen Konto. Dann gelten für sie dieselben Rechte wie für alle anderen.
- Wo ein einfacher Workflow reicht, braucht es keine KI.
- Am Anfang steht ein abgegrenzter Ablauf an Ihren eigenen Dokumenten. Danach können Sie Erkennungsqualität, Nacharbeit und laufende Kosten beurteilen.
Der übliche Anfang: ein privates Konto und viel Kopieren
Ein privater Chat weiß nichts über Ihren Betrieb. Das Modell kennt weder Ihre Preise noch Ihre Kunden noch die Absprachen vom letzten Jahr. Was fehlt, ergänzt es mit dem, was in solchen Fällen üblich ist. Das klingt flüssig und passt oft nicht. Ein Angebotstext mit falschen Zahlungsbedingungen oder eine Antwort, die eine längst geklärte Frage neu aufrollt, fällt erst auf, wenn jemand genau liest.
Mehr hineinzukopieren hilft nur begrenzt. Lange, ungeordnete Texte machen die Antworten nicht zuverlässiger. Anthropic, der Hersteller der Claude-Modelle, beschreibt die Aufmerksamkeit eines Modells als knappes Budget: Mit jedem zusätzlichen Text sinkt die Chance, dass es das Wichtige darin genau erfasst. Gesucht ist deshalb die kleinste Menge an Information, die für die Aufgabe nötig ist.
Dazu kommt Wissen, das verloren geht. Was eine Mitarbeiterin der KI über Ihre Abläufe erklärt hat, steht in ihrem privaten Verlauf. Der Kollege nebenan fängt bei null an. Wer den Betrieb verlässt, nimmt den Verlauf mit.
Und die Daten verlassen den Betrieb ohne Vertrag. Bei den Verbrauchertarifen von ChatGPT (Free, Plus und Pro) ist voreingestellt, dass Gespräche in das Training künftiger Modelle einfließen, bis jemand das in den Einstellungen abschaltet. Bei Claude entscheiden Nutzer von Free, Pro und Max selbst darüber. Stimmen sie zu, bewahrt Anthropic die Gespräche bis zu fünf Jahre auf. Für die Geschäftstarife beider Anbieter gilt das nicht: Dort werden Eingaben standardmäßig nicht zum Training verwendet und es gibt einen Vertrag zur Auftragsverarbeitung. Stand ist November 2026, die Bedingungen ändern sich.
Ein Verbot löst das selten, denn die Arbeit muss trotzdem erledigt werden. Besser ist ein freigegebener Zugang mit dienstlichem Konto, Vertrag und abgeschaltetem Training, dazu kurze Regeln, welche Daten hineindürfen. Das ist die Voraussetzung. Bessere Antworten bringt erst der nächste Schritt.
Context Engineering: was die KI zu einer Aufgabe zu sehen bekommt
Context Engineering heißt, vorab festzulegen, welche Informationen ein Modell zu einer Aufgabe bekommt, in welcher Form und zu welchem Zeitpunkt. Anthropic beschreibt es als Weiterentwicklung des Prompt Engineering. Es geht weniger um die perfekte Anweisung an die KI als um die Frage, was bei jeder Anfrage im Kontext steht. In einem Betrieb sind das drei Arten von Information:
- Feste Regeln, die immer gelten: wer Sie sind, welche Begriffe Sie verwenden, wie Sie Kunden ansprechen und was die KI nie tun darf. Kurz gehalten und an einer Stelle gepflegt.
- Wissen bei Bedarf: Arbeitsanweisungen, Handbücher, frühere Antworten. Es liegt in einem Wiki oder einer Dokumentenablage und wird zu einer Frage gezielt herausgesucht, statt immer mitzulaufen. Die übliche Technik dafür heißt Retrieval Augmented Generation, kurz RAG.
- Daten per Abfrage: Prüftermine, Beträge, Zuständigkeiten, Status. Sie kommen über Felder und Schnittstellen aus den Systemen, die Sie schon nutzen.
So arbeiten wir selbst. Jede KI-Sitzung bei uns liest zuerst eine Datei mit den Regeln, die immer gelten. Danach durchsucht sie unser Wiki nach dem Thema der Aufgabe. Entscheidungen stehen an einer Stelle, mit Datum und Status. Weder ein neues Gespräch noch ein anderes Modell fängt deshalb bei null an.
Für die ersten beiden Arten reichen ein gepflegtes Wiki und eine geordnete Ablage. Nach unserer Erfahrung fehlt am häufigsten die dritte. Sie entscheidet darüber, ob eine Antwort vollständig ist.
KI im Unternehmen: Warum ein weiteres Werkzeug nicht reicht
Ein typisches Bild: Prüfprotokolle liegen als PDF in Ordnern auf dem Server, Rechnungen im Postfach der Buchhaltung, Servicefälle in E-Mails und das Wissen über Zuständigkeiten in den Köpfen. Fragt jemand die KI, welche Anlagen im nächsten Monat zur Prüfung fällig sind, muss sie suchen, lesen und zusammensetzen. Bei jeder Frage von vorn und ohne dass jemand sicher sagen kann, ob sie alle Protokolle gefunden hat.
Ein weiteres Werkzeug löst das nicht. Solange die Daten ungeordnet sind, stößt jeder neue Anwendungsfall wieder auf dasselbe Problem.
Das deckt sich mit einer Umfrage von Gartner unter 1.203 Verantwortlichen für Datenmanagement aus dem Juli 2024: 63 Prozent der Organisationen haben keine passenden Verfahren, um Daten für KI aufzubereiten, oder wissen nicht, ob sie welche haben. Gartner leitet daraus die Prognose ab, dass Organisationen bis Ende 2026 60 Prozent der KI-Projekte aufgeben, denen solche Daten fehlen. Das ist eine Prognose und keine Messung. Befragt wurden auch nicht speziell kleine Unternehmen.
Was ein KI-Fundament ist
Wir verstehen darunter drei Dinge, die zusammengehören:
- Strukturierte Daten. Was eine KI immer wieder braucht, liegt als Feld vor: Prüftermine, Anlagen, Beträge, Lieferanten, Zuständigkeiten. Das Dokument bleibt die Quelle, das Feld ist der direkte Weg zur Antwort.
- Klare Regeln. Die KI arbeitet mit einem eigenen Konto und festgelegten Rechten. Was sie lesen, ändern oder versenden darf, steht vorher fest und nicht erst in einer Anweisung an das Modell.
- Anbindungen. Schnittstellen verbinden die KI mit den Systemen, die Sie schon nutzen: Dokumentenablage, Ticketsystem, Wiki, Microsoft 365.
Auf dieser Grundlage arbeitet die KI mit dem ganzen Zusammenhang, statt jedes Mal neu zu suchen. Das macht sie günstiger, schneller und nachvollziehbar. Felder gibt es nicht nur in einer Dokumentenablage wie Paperless-ngx. In SharePoint heißen sie Spalten und leisten dasselbe, eine neue Ablage ist dafür nicht nötig.
Die Reihenfolge zählt. Ein Agent, der auf einer ungeordneten Ablage aufsetzt, muss die fehlende Ordnung selbst ausgleichen: Er sucht nach Dateinamen, schließt aus Ordnerpfaden und liest lange Dokumente, um ein Datum zu finden. Wird die Ablage später geordnet, passen diese Umwege nicht mehr und der Agent muss neu eingerichtet werden. Felder, Rechte und Anbindungen dagegen bleiben, auch wenn das Modell wechselt oder ein weiterer Agent dazukommt.
Felder statt Textsuche: warum das Kosten spart
Sprachmodelle rechnen nach Tokens ab. Ein Token ist ein Wortteil, abgerechnet wird also nach der Textmenge, die ein Modell liest und schreibt. Wer ein Modell Fragen zu eigenen Dokumenten beantworten lässt, bezahlt für die Textstellen, die es dafür liest, bei jeder Frage aufs Neue. Mit der Zahl der Dokumente und der Fragen wächst diese Menge.
Nehmen Sie die Frage, welche Anlagen im nächsten Monat zur Prüfung fällig sind. Ohne Felder sucht die KI in den Prüfprotokollen nach passenden Textstellen, liest Prüfdatum und Intervall heraus und rechnet den nächsten Termin aus. Mit einem Feld für den nächsten Prüftermin ist es eine Abfrage. Die KI liest jedes Protokoll einmal, beim Erfassen. Danach verarbeitet sie für eine Frage nur noch das Ergebnis der Abfrage und formuliert daraus die Antwort. Ob sich die Erfassung lohnt, hängt davon ab, wie oft die Frage gestellt wird und wie viel Pflege die Felder brauchen.
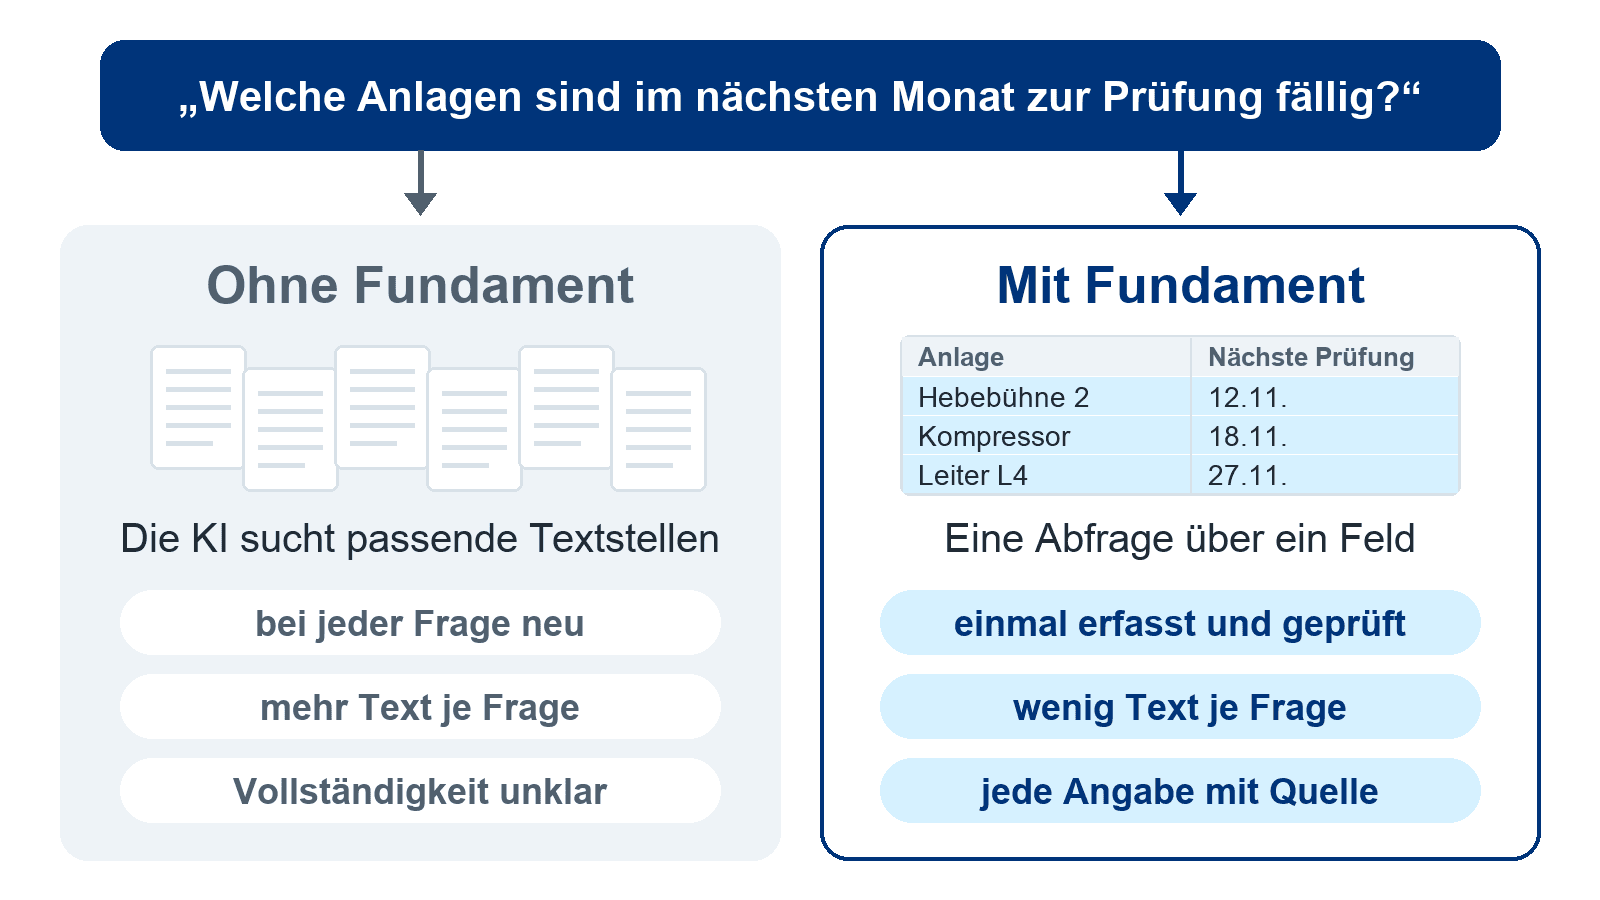
Tabelle seitlich verschieben →
| Frage | Ohne Felder | Mit Feldern |
|---|---|---|
| Welche Anlagen sind im nächsten Monat zur Prüfung fällig? | Passende Stellen in den Prüfprotokollen suchen, Prüfdatum und Intervall herauslesen, Termin ausrechnen. Bei jeder Frage neu. | Eine Abfrage über das Feld nächster Prüftermin. |
| Was haben wir dieses Jahr bei einem Lieferanten eingekauft? | Rechnungen des Lieferanten suchen und die Beträge zusammenzählen. Fehlt eine Rechnung im Suchergebnis, fällt es nicht auf. | Eine Summe über das Feld Betrag, gefiltert nach Lieferant und Jahr. |
| Welche Mängel aus den letzten Prüfungen sind noch offen? | Protokolle nach Bemerkungen durchsuchen. Ob ein Mangel inzwischen behoben ist, steht oft an anderer Stelle. | Ein Datensatz je Mangel mit Status, verknüpft mit Anlage und Protokoll. |
| Wie prüfen wir Leitern und Tritte? | Hier passt die Suche im Text: Die KI findet die Arbeitsanweisung und fasst sie zusammen. | Kein Feld nötig. |
Hier liegt auch die Grenze von RAG. Die Suche gibt dem Modell zu einer Frage die passendsten Textstellen mit. Für die Frage nach der Arbeitsanweisung funktioniert das gut. Für die Frage, welche Prüfungen fällig sind, nicht zuverlässig, denn die Suche liefert die ähnlichsten Stellen und nicht alle. Fragen nach Vollständigkeit, Summen und Fristen gehören in Felder.
Auch Felder haben eine Grenze. Eine Abfrage findet alle passenden erfassten Datensätze. Dass alle Anlagen, Rechnungen und Prüfungen erfasst sind, beweist sie nicht. Deshalb gehört zum Fundament auch die Frage, auf welchem Weg neue Dokumente zuverlässig hineinkommen.
Nachvollziehbar statt überzeugend formuliert
Sprachmodelle formulieren auch dann flüssig, wenn sie falsch liegen. Gegen solche Halluzinationen hilft eine prüfbare Quelle mehr als jede ausgefeilte Anweisung. Liegt ein Prüftermin als Feld vor, nennt die KI den Wert und das Protokoll, aus dem er stammt. Wer die Antwort prüfen will, öffnet das Protokoll. Fehlt ein Wert, wird er als unbekannt ausgegeben. Das legen wir beim Einrichten ausdrücklich fest, statt es dem Modell zu überlassen.
Geprüfte Felder verringern die wiederholte Kontrolle am Original. Sie ersetzen sie nicht: Auch eine Abfrage kann falsch gefiltert sein und auch eine Antwort aus richtigen Feldern kann falsch zusammengefasst werden. Wie genau eine Antwort geprüft wird, richtet sich nach dem Risiko. Eine Übersicht fälliger Prüfungen braucht eine andere Kontrolle als eine Mail an einen Kunden.
Berechtigungen gehören an den Anfang
Die einfachste Regel lautet: Die KI arbeitet mit einem eigenen Konto, wie ein neuer Mitarbeiter. Dann gelten für sie dieselben Rechte wie für alle anderen. In Paperless-ngx lassen sich Dokumenten ein Eigentümer sowie Rechte zum Ansehen und Bearbeiten für Benutzer und Gruppen zuweisen. Dokumente ohne Eigentümer sind dort für alle Benutzer sichtbar, also auch für das Konto der KI. Sie müssen deshalb vor dem Start geprüft werden. In Microsoft 365 regeln Entra ID und die Freigaben in SharePoint, wer was sieht. Was das Konto der KI nicht sehen darf, kann sie auch nicht weitergeben.
Auch automatische Abläufe ohne angemeldeten Menschen bekommen ein eigenes Konto mit genau den Rechten, die die Aufgabe braucht. Für eine Auswertung reicht Lesen. Die Verbindung zu den Systemen läuft über Schnittstellen oder MCP (siehe häufige Fragen). Welche Daten darüber erreichbar sind, entscheiden die Rechte des Kontos dahinter.
Nachträglich lassen sich Rechte nur mühsam einziehen. Ein Agent, der einmal auf alles zugreifen durfte, hat Abläufe, die genau davon ausgehen. Wer sie einschränkt, muss die Abläufe neu einrichten.
Was Copilot über Ihre Freigaben verrät
Microsoft beschreibt das Prinzip selbst: Microsoft 365 Copilot, inzwischen „Microsoft Copilot“, zeigt nur Unternehmensdaten an, die der jeweilige Benutzer mindestens ansehen darf. Das ist eine Obergrenze und keine Zusage, dass Copilot alles einbezieht, was ein Benutzer öffnen kann. In unserem eigenen Test kam Copilot zum Beispiel nicht an freigegebene Postfächer heran, obwohl das Konto Administratorrechte hatte.
Die Obergrenze hat trotzdem Folgen. Ist ein Ordner mit Personalunterlagen versehentlich für alle freigegeben, kann Copilot Inhalte daraus jedem zeigen, der danach fragt. Vorher fiel eine zu weite Freigabe kaum auf, weil niemand den Ordner suchte. Copilot sucht für jeden. Deshalb steht vor der Einführung die Frage, wer heute was sehen kann. Das ist keine Datenschutzfrage am Rande, sondern die Voraussetzung dafür, dass Copilot im Unternehmen breit eingesetzt werden kann.
Wo Kundendaten verarbeitet werden
Ein Geschäftskonto regelt, wer Ihre Eingaben verarbeitet und dass sie standardmäßig nicht dem Training dienen. Wo die Verarbeitung stattfindet, ist eine eigene Frage. Die großen Modelle betreiben überwiegend Anbieter aus den USA. Wo genau die Daten verarbeitet werden, regeln die Bedingungen des jeweiligen Tarifs.
Für Kundendaten, die Deutschland nicht verlassen sollen, gibt es offene Sprachmodelle, die in deutschen Rechenzentren betrieben werden. Ob ein solches Modell eine Aufgabe so gut löst wie ein großes, prüfen wir am konkreten Ablauf, bevor er in Betrieb geht. Gesundheitsdaten und andere besondere Kategorien personenbezogener Daten nach Art. 9 DSGVO geben wir grundsätzlich nicht in KI-Dienste.
KI, wo sie hilft. Ein Skript, wo es reicht.
Nicht jede Aufgabe braucht ein Sprachmodell. Sobald der nächste Prüftermin als Datumsfeld vorliegt, kann ein Workflow in Paperless-ngx eine festgelegte Zahl von Tagen vor diesem Datum eine Wiedervorlage auslösen. Das ist eine Standardfunktion, ohne KI und ohne laufende Tokenkosten. Die KI wird dort gebraucht, wo Text verstanden werden muss: beim Erfassen eines neuen Protokolls oder einer Rechnung oder bei einer offenen Frage, die keine Abfrage abdeckt.
Wir arbeiten unabhängig von Plattformen. Ob ein Ablauf über Copilot, über eine KI-Plattform, über ein Modell per Schnittstelle oder über ein einfaches Skript läuft, entscheidet die Aufgabe. Je weniger ein Ablauf an einem einzelnen Anbieter hängt, desto leichter ist ein Wechsel, wenn sich Preise oder Modelle ändern.
Ihre Systeme bleiben im Standard
Wir verändern Software nicht im Quellcode, sondern nutzen, was sie vorsieht: benutzerdefinierte Felder, Rechte, Workflows und Schnittstellen. Ein Fork, also eine eigene Abspaltung der Software, müsste bei jedem Update nachgezogen werden. Im Standard bleiben Ihre Systeme updatefähig.
Was darüber hinausgeht, kommt als eigene Schicht dazu: ein Export für die Buchhaltung, eine Auswertung für das Controlling, eine Übersicht für die Werkstattleitung. Diese Schicht liest über die Schnittstelle und lässt das System darunter unverändert.
KI-Readiness: fünf Fragen für eine erste Einschätzung
KI-Readiness meint, ob Daten, Rechte und Abläufe so weit sind, dass eine KI damit verlässlich arbeiten kann. Für eine erste Einschätzung genügen fünf Fragen:
- Welche KI-Dienste nutzen Ihre Mitarbeiter heute und mit welchem Konto?
- Lässt sich die Frage, die eine KI beantworten soll, heute mit einer Abfrage beantworten oder nur durch Suchen und Lesen?
- Wissen Sie, wer heute welche Ordner, Postfächer und Dokumente sehen kann?
- Woran erkennen Sie, ob eine Antwort stimmt?
- Wie oft fällt die Aufgabe an und wie viel Arbeit kostet sie heute?
Sind die Antworten klar, kann es direkt mit einem Ablauf losgehen. Wo eine Antwort unklar bleibt, beginnt das Fundament. Und fällt eine Aufgabe nur selten an, lohnt sich oft weder das eine noch das andere.
Was wir versprechen und was nicht
Wir versprechen nicht, dass KI in Ihrem Unternehmen funktioniert. Das kann vorher niemand seriös sagen, denn es hängt an Ihren Dokumenten, Ihren Systemen und Ihren Fragen. Wir versprechen, dass Sie es nach dem ersten Ablauf beurteilen können. Prozentwerte zur Zeitersparnis nennen wir deshalb vorab nicht. Sie hängen an Ihren Daten und Abläufen und nach dem ersten Ablauf haben Sie Ihre eigenen Zahlen.
Dazu wählen wir mit Ihnen einen abgegrenzten Ablauf, dort, wo heute am meisten Zeit verloren geht. Diesen richten wir an einem Ausschnitt Ihrer eigenen Dokumente ein: Felder festlegen, von der KI erfassen lassen, Rechte setzen, Fragen stellen. Die erfassten Felder prüfen wir an diesem Ausschnitt gegen die Originale. So wird messbar, wie zuverlässig die Erkennung ist. Liegen die Dokumente schon digital vor, ist die Technik dabei eine Sache von Stunden. Die meiste Zeit braucht eine Entscheidung auf Ihrer Seite: welche Frage Sie wirklich beantwortet haben wollen und welche Angaben dafür maschinenlesbar werden müssen. Dabei helfen wir, entscheiden müssen Sie. Im laufenden Betrieb richtet sich die Kontrolle danach, was ein Fehler kosten würde.
Danach können Sie vier Dinge beurteilen: wie zuverlässig die Felder erkannt werden, wie viel Nacharbeit bleibt, was der Ablauf im laufenden Betrieb ungefähr kostet und wo seine Grenzen liegen. Lohnt sich der Ausbau, wächst der Ablauf weiter. Lohnt er sich nicht, wissen Sie es früh.
Woran Sie ein belastbares KI-Angebot erkennen
Wer KI-Beratung sucht, findet viele Versprechen. Diese Fragen helfen, sie einzuordnen, auch bei uns:
- Gibt es zu Prozentwerten und eingesparten Arbeitstagen eine Quelle, eine Stichprobe und einen Zeitraum?
- Steht dort nur „DSGVO-konform“ oder steht dort, wo die Daten verarbeitet werden, welche Anbieter beteiligt sind und welcher Vertrag zur Auftragsverarbeitung gilt?
- Wird ein Return on Investment zugesagt, bevor jemand Ihre Daten gesehen hat?
- Was steht hinter den Logos auf der Website: ein Projekt, eine Schulung oder ein einzelner Teilnehmer?
- Kann der Anbieter erklären, mit welchem Konto und welchen Rechten die KI auf Ihre Daten zugreift?
- Passt die Datenschutzerklärung des Anbieters zu seinen Versprechen? Wer mit Ihren Daten arbeiten will, sollte bei den eigenen Daten Ordnung halten.
Keine dieser Fragen verlangt Fachwissen. Ein Anbieter, der seine Arbeit kennt, beantwortet sie ohne Umschweife.
Wir arbeiten selbst so
Unseren eigenen Betrieb führen wir nach denselben Regeln. Vorgänge, Wissen, Dokumente, Zeiten und Kontakte liegen in Systemen mit Schnittstelle und KI-Agenten arbeiten darin mit. Einige Regeln, die sich dabei bewährt haben:
- Agenten melden sich mit eigenen Dienstkonten an, im Ticketsystem, im Wiki, in der Zeiterfassung und im CRM, nicht mit dem Zugang des Geschäftsführers.
- Was ein Agent ohne Rückfrage darf, ist in Stufen festgelegt. Notizen schreiben und Vorgänge sortieren darf er, eine Mail an Kunden versenden nur nach Freigabe.
- Welches Modell auf welche Daten zugreifen darf, ist je Modell festgelegt. Nicht jedes Modell sieht Kundendaten.
- Jede Wiki-Seite nennt, wer sie pflegt. Seiten, die ein Mensch pflegt, ändert kein Agent.
- Neue Regeln für den Posteingang werden zuerst an nachgestellten Mails geprüft und erst dann eingeschaltet.
- Bevor eine Änderung an der Website online geht, laufen automatische Prüfungen, darunter Testfragen an unseren Assistenten und ein Abgleich seiner Texte mit unseren Formulierungsregeln.
- Auf die Buchhaltung greifen Agenten nur lesend zu.
Diese Regeln sind nicht für eine Präsentation entstanden, sondern weil wir täglich mit ihnen arbeiten. Was dabei nicht funktioniert, merken wir zuerst bei uns.